
科学家发布开源RNA序列基础模型



文章导读
海量RNA序列数据背后,结构与功能解析仍是瓶颈。中国科学技术大学MIRACLE实验室发布开源RNA序列基础模型structRFM,将结构知识融入约2100万条序列-二级结构配对数据的预训练,仅输入序列即可提取多级特征,在结构预测与剪接位点、内部核糖体进入位点识别及非编码RNA分类等任务中达到国际前沿水平。成果发表于《自然》,数据、权重和源代码均已开放,它能否成为RNA研究与药物发现的可复用基座?
— 内容由好学术AI分析文章内容生成,仅供参考。
近日,中国科学技术大学医学影像智能与机器人(MIRACLE)实验室发布了一款开源RNA(核糖核酸)序列基础模型structRFM,有效提高AI模型在RNA结构预测与功能推断一系列下游任务中的性能,有望助力人工智能驱动的科学研究、生物学机制理解、药物发现等。
RNA是重要的生物大分子,存在于生物细胞以及部分病毒、类病毒中,广泛参与蛋白质合成、基因表达调控和RNA剪接等生命过程。解析RNA参与序列、折叠结构相关的联系,是揭示其生物学机制的重要基础,也是药物发现的支撑要素。
随着测序技术发展,此前研究积累了海量RNA序列数据。借鉴AI自然语言处理中的预训练方法,RNA序列基础模型能够从这些数据中学习序列规律,提取可用于不同任务的通用特征,为结构预测和功能分析提供支持。
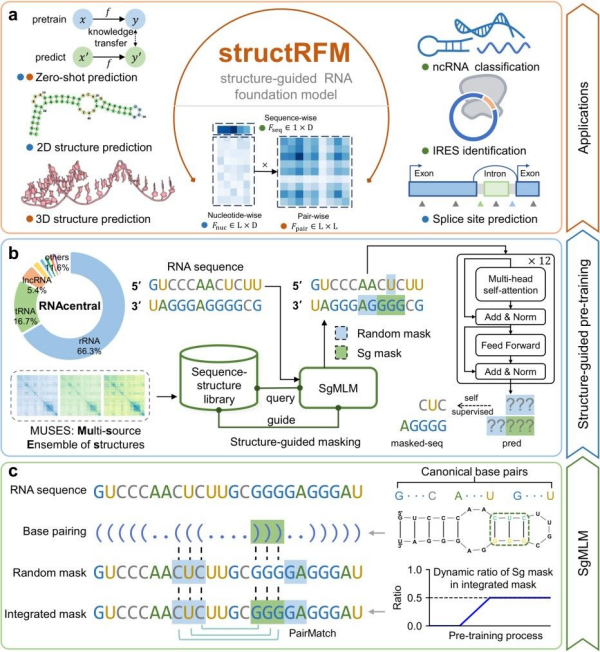
研究团队将结构知识融入大规模序列学习,并保持模型在不同结构与功能任务中的适应性和泛化能力,研发出RNA序列基础模型structRFM。
团队首先构建了约2100万条经计算注释的序列-二级结构配对数据。在此基础上,设计算法同时预训练学习序列上下文与结构依赖。预训练后的模型仅需输入序列,即可提取序列级、核苷酸级和核苷酸对级特征,用于多种结构与功能推断任务,并在多项任务中达到国际前沿水平。
实验显示,structRFM在零样本同源性分类中表现良好,并提高了二级结构预测性能;将其特征融入三级结构预测模型后,也改善了三维结构及其对应二级结构的预测结果。在功能推断方面,模型支持剪接位点预测、内部核糖体进入位点识别和非编码RNA分类。
此外,模型在新发布的RNA家族上保持较好的二级结构预测表现,并通过分段策略扩展至长非编码RNA分类。消融实验进一步验证了结构信息的引入及掩码策略对模型性能提升的作用,为算法设计提供了实验支持。
目前,团队已开放完整配对数据、模型权重和源代码,为研究结果的复现和相关模型的开发提供了可复用资源。
相关研究成果发表在《自然》(Nature)上。
RNA序列基础模型
© 版权声明
本文由分享者转载或发布,内容仅供学习和交流,版权归原文作者所有。如有侵权,请留言联系更正或删除。




相关文章




AI用在生物大分子上真是越来越成熟了
这个方向挺前沿的,数据全开源这点很实在
好奇这个模型对长链RNA的效果怎么样
2100万条配对数据,这个规模不小啊
RNA结构预测一直挺难的,能发Nature说明确实有两下子